Сначала мы выбросили DQL, partial managed entities, EXTRA_LAZY и ряд совместимых режимов, которые усложняли внутреннюю модель. Затем ограничили платформу современным PHP и PostgreSQL. На этой основе появились SQL-first запросы, пакетная загрузка связей, bulk, JSONB, полнотекстовый поиск и измеримая работа UnitOfWork.
В этой статье разбираем, какую пользу это даёт разработчику: от списка заказов без сотни SELECT до импорта без цикла по объектам. ModernORM выросла из Doctrine ORM 3.7.6 и сохраняет соответствующие MIT-уведомления; сейчас это самостоятельная библиотека со своим API и ограничениями.
Содержание статьи
- 1. Сначала мы убрали то, за что не хотим платить сложностью
- 2. Ограничения: PHP 8.4+, PostgreSQL и современный DBAL
- 3. SQL-first: знакомый SQL, результатом остаются сущности
- 4. Batch fetching: меньше запросов без огромного fetch join
- 5. Посчитать и отфильтровать связь можно прямо в SQL
- 6. Массовый импорт — отдельный API, а не цикл из persist()
- 7. JSONB и полнотекстовый поиск становятся частью mapping и запросов
- 8. Курсорная пагинация вместо всё более глубокого OFFSET
- 9. php-ext-deepclone: ускорение гидратации
- 10. Кеш и встроенные поведения — с явными границами
- 11. SQL, flush и hydration можно наблюдать из самой ORM
- 12. Как мы рефакторили UnitOfWork: выделяли алгоритмы и контракты
- 13. Корректность: что исправляли помимо производительности
- 14. Ускорения: что изменили и где измеряли результат
- 15. Что показывают измерения и чего они не обещают
- 16. Как начать новый проект
- 17. Когда имеет смысл перейти с Doctrine ORM
1. Сначала мы убрали то, за что не хотим платить сложностью
Мы начали ModernORM с сокращения поддерживаемого контракта. Для проекта, который заранее выбирает PostgreSQL и современный PHP, не каждая историческая возможность универсальной ORM полезнее своей стоимости поддержки. Наш выбор — сохранить знакомую работу с сущностями и сделать доступ к данным более явным.
| Что убрали | Что используем вместо этого | Выгода разработчику |
|---|---|---|
| DQL, парсер, AST walkers и DQL-функции | SQL QueryBuilder с гидратацией сущностей | Один язык запросов с PostgreSQL-выражениями, без второго синтаксического слоя |
| Частично загруженные managed-сущности | Полная проекция сущности либо отдельные строки / DTO | Объект в Identity Map не маскирует недостающие поля |
| EXTRA_LAZY | Явный Association Query API | Видно, когда считаем данные в БД, а когда работаем с коллекцией в памяти |
| Наследование сущностей и discriminator mapping | Обычные сущности, композиция, MappedSuperclass | Меньше вариантов SQL и состояния при загрузке |
| Составные и ассоциативные ID сущностей | Один скалярный первичный ключ | Проще идентичность, batching и курсоры |
| XML/YAML/аннотации mapping | PHP-атрибуты ModernORM | Описание модели находится рядом с PHP-классом |
| ORM Filters и трансляция Criteria в SQL | Явные условия запроса и отдельные встроенные политики | Меньше скрытого изменения запроса |
| Сборку вложенного графа в array hydration | Плоские результаты либо управляемый объектный граф | Предсказуемый формат выдачи и границы памяти |
| Генерируемые proxy-классы и совместимость со старым PHP | Native lazy objects PHP 8.4 | Нет отдельного слоя генерации PHP-классов |
| Каскадные refresh и detach | Явная операция над корневой сущностью | Меньше неочевидных изменений в соседних объектах |
Здесь важна точность терминов. Мы убрали partial managed entities, но не запретили выбирать два столбца для отчёта. Мы отказались от вложенных array-графов, но сохранили объектную загрузку связей. Обычное PHP-наследование, MappedSuperclass и embeddables также остаются. Сокращение возможностей затрагивает определённые механизмы ORM, а не сам объектный подход.
Управление идентичностью, persist(), flush(), lazy-связи, поддерживаемые каскады и orphan removal сохраняют привычный рабочий процесс. При этом это самостоятельная ORM: совместимость DQL, Doctrine QueryBuilder и сторонних расширений не подразумевается.
Подробности: матрица совместимости, удаление partial managed entities и замена EXTRA_LAZY.
2. Ограничения: PHP 8.4+, PostgreSQL и современный DBAL
ModernORM требует PHP 8.4+ и работает только с PostgreSQL. В текущем Composer-контракте указаны PHP ^8.4, DBAL ^4.6, ext-pdo и ext-pdo_pgsql. Для FullTextIndex дополнительно требуется PostgreSQL 17+. Требования конкретных возможностей нужно учитывать отдельно от базового CRUD.
Это определяет, кому мы предлагаем библиотеку. Если новый сервис строится на PostgreSQL, можно сразу проектировать SQL, JSONB, полнотекстовый поиск и массовые записи под выбранную СУБД. Если приложение обязано работать с несколькими движками, такая специализация не соответствует его требованиям.
ModernORM использует DBAL и другие компоненты экосистемы Doctrine. Изменение архитектуры ORM не означает отказа от всех проверенных низкоуровневых библиотек. В частности, DBAL остаётся слоем соединения, типов и построения SQL.
Релиз ORM beta.5 · Релиз Bundle beta.5.
Требования и статус публикации: composer.json и CHANGELOG. Сначала мы покажем, за счёт чего эта специализация приносит пользу, затем разберём переход существующего проекта.
3. SQL-first: знакомый SQL, результатом остаются сущности
В DQL-запросах разработчик оперирует моделью ORM, а затем изучает получившийся SQL. В ModernORM запрос сразу строится в SQL-терминах. При этом не нужно вручную создавать объекты после каждого SELECT: fromEntity() готовит полную проекцию и mapping результата.
Возьмём простую модель товара. Этот класс используется в примерах запросов и массового импорта ниже.
use ModernORM\Mapping as ORM;

#[ORM\Entity]
#[ORM\Table(name: 'products')]
class Product
{
    #[ORM\Id, ORM\Column(type: 'integer'), ORM\GeneratedValue]
    public ?int $id = null;

    #[ORM\Column(length: 64, unique: true)]
    public string $sku;

    #[ORM\Column(type: 'text')]
    public string $name;

    #[ORM\Column(type: 'decimal', precision: 12, scale: 2)]
    public string $price = '0.00';

    #[ORM\Column(type: 'jsonb')]
    public mixed $attributes = [];
}
Обычное сохранение выглядит знакомо. Предполагаем, что $em — настроенный EntityManager ModernORM; ниже приведены отдельные примеры, а не один скрипт для последовательного запуска.
$product = new Product();
$product->sku = 'PUMP-100';
$product->name = 'Насос';
$product->price = '12500.00';
$product->attributes = ['brand' => 'ACME', 'voltage' => 220];

$em->persist($product);
$em->flush();
Выборка сущностей сохраняет Identity Map и обычное отслеживание изменений:
$qb = $em->createQueryBuilder()->fromEntity(Product::class, 'p');
$products = $qb
    ->where($qb->column('p', 'sku').' = :sku')
    ->setParameter('sku', 'PUMP-100')
    ->getQuery()
    ->getResult();
В SQL-выражениях используются физические имена колонок. Метод column() явно разрешает PHP-поле в соответствующую колонку, в том числе для embedded-полей. Значения передаются параметрами; произвольный SQL-фрагмент не становится безопасным только из-за использования QueryBuilder.
Если нужны строки для отчёта, не создаём managed-сущности вообще:
$rows = $em->createQueryBuilder()
    ->select('p.sku', 'p.price')
    ->from('products', 'p')
    ->where('p.price >= :minimum')
    ->setParameter('minimum', '1000.00')
    ->executeQuery()
    ->fetchAllAssociative();
Выгода: можно выбрать стоимость абстракции под задачу. Для доменной работы — сущности; для выгрузки — строки. Partial load для этого не нужен. SQL JOIN, CTE и PostgreSQL-выражения не приходится сначала представлять в отдельном языке ORM. Контракт SQL API.
4. Batch fetching: меньше запросов без огромного fetch join
Классический сценарий: загрузили 100 заказов, затем в цикле обратились к 100 разным клиентам. Без пакетной загрузки получается один SELECT заказов и ещё 100 SELECT клиентов. Для такой задачи мы добавили batching в атрибуты связей.
Фрагмент mapping заказа — идентификатор, таблица и остальные поля здесь опущены:
use ModernORM\Mapping as ORM;

#[ORM\ManyToOne(targetEntity: Customer::class, batchSize: 32)]
public Customer $customer;
$orders = $em->getRepository(Order::class)->findBy([], ['id' => 'ASC']);
foreach ($orders as $order) {
echo $order->customer->name;
}При обращении к ожидающей lazy-ссылке ORM загружает совместимые ссылки группой через IN. В зафиксированном сценарии с 100 разными клиентами размер группы 32 дал 5 SELECT вместо 101: один запрос заказов и четыре группы клиентов. Это конкретный воспроизводимый пример, не обещание одинакового числа запросов для любого графа.
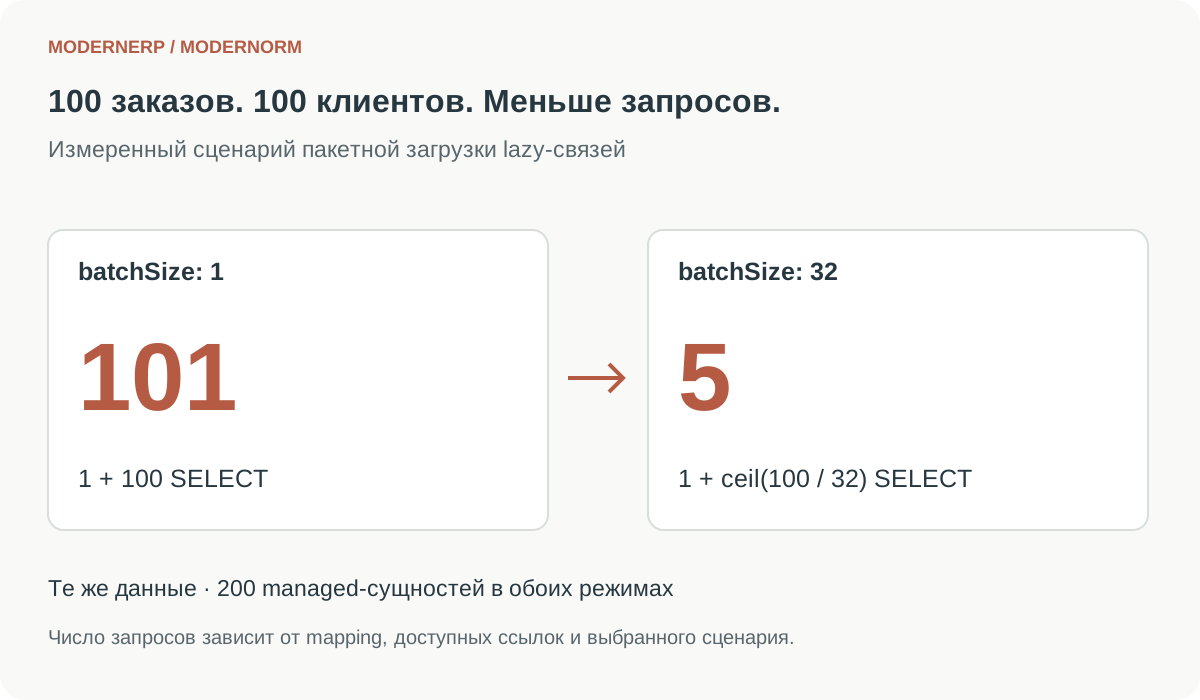
Пакетная загрузка доступна также для OneToMany и ManyToMany. Результаты распределяются по коллекциям владельцев. Batching включается явно; batchSize: 1 отключает его для конкретной связи.
Выгода: сохраняется обычная навигация по модели, при этом уменьшается число сетевых обращений к БД. Для длинных списков это часто практичнее, чем один JOIN, размножающий строки корня. Ограничения и измерения: batch fetching и зафиксированный workload.
5. Посчитать и отфильтровать связь можно прямо в SQL
После удаления EXTRA_LAZY мы разделили два действия: работу с коллекцией объектов в памяти и явный запрос к данным связи в БД. Для второго есть Association Query API.
// $order — уже сохранённый заказ, управляемый этим EntityManager.
$items = $em->association($order, 'items');

$count = $items->count();
$containsItem = $items->exists($itemId);

$page = $items
    ->where('status', 'active')
    ->orderBy('id', 'ASC')
    ->page(limit: 50);

foreach ($page->getItems() as $item) {
    // Работаем с сущностями выбранной страницы.
}
count() выполняет COUNT, exists() проверяет принадлежность целевой записи именно этой связи. Полная коллекция для этого не инициализируется. Фильтрация использует PHP-поля целевой сущности, а значения связываются с mapped-типами.
Эти запросы читают БД в текущей транзакции и не делают автоматический flush. Добавление объекта в коллекцию только в памяти не обязано изменить SQL COUNT до сохранения. Такое разделение делает источник результата явным.
Выгода: список строк заказа, участников проекта или документов клиента не нужно загружать целиком ради счётчика, проверки доступа к конкретной связи или первой страницы. Association Query API. Проверки полномочий пользователя и tenant-условия по-прежнему задаёт приложение.
6. Массовый импорт — отдельный API, а не цикл из persist()
Сохранение доменного объекта и импорт десятков тысяч строк имеют разные требования. В первом важны lifecycle и отслеживание состояния; во втором часто нужны PostgreSQL UPSERT и возврат ключей. Мы сделали этот выбор явным.
use ModernORM\Bulk\BulkPolicy;

$result = $em->bulk()->upsert(Product::class, [
    ['sku' => 'PUMP-100', 'name' => 'Насос',
     'price' => '12500.00', 'attributes' => ['voltage' => 220]],
    ['sku' => 'VALVE-200', 'name' => 'Клапан',
     'price' => '750.00', 'attributes' => []],
], conflictFields: ['sku'], updateFields: ['name', 'price', 'attributes'],
   policy: BulkPolicy::CLEAR, returning: ['id', 'sku']);
Помимо UPSERT есть массовые INSERT, UPDATE и DELETE, а также поддерживаемые операции soft delete/restore. Bulk не запускает обычные callbacks для каждой строки и не сохраняет автоматически ожидающие изменения сущностей.
BYPASSоставляет managed-контекст как есть: уже загруженные объекты могут стать устаревшими.CLEARпосле успеха отсоединяет весь контекст и отбрасывает несохранённую работу. Это нужно учитывать до вызова.
Конфликтное поле в примере защищено UNIQUE-ограничением; конфликтный ключ и обновляемые поля задаются явно. Размер пакетов планирует приложение: Bulk API не означает автоматическое разбиение любого массива на безопасные чанки.
Выгода: разработчик получает инструмент для импорта прайсов, остатков и интеграционных пакетов без маскировки другой семантики под обычный flush(). Контракт bulk-операций.
7. JSONB и полнотекстовый поиск становятся частью mapping и запросов
JSONB без ручного склеивания параметров
Для товара с дополнительными характеристиками можно выразить содержимое JSONB и числовое условие через mapped-поле:
$qb = $em->createQueryBuilder()->fromEntity(Product::class, 'p');
$data = $qb->jsonb('p', 'attributes');

$products = $qb
    ->andWhere($data->contains(['brand' => 'ACME']))
    ->andWhere($data->path(['voltage'])->compareNumber('>=', 220))
    ->getQuery()
    ->getResult();
Ключи, пути и значения связываются параметрами. API различает JSON-число и строку, отсутствующий путь, JSON null и SQL NULL. Это помогает сохранить смысл данных, а не просто сократить длину SQL. Индексы и анализ плана запроса остаются задачей схемы и измерений. JSONB Query API.
Полнотекстовый индекс рядом с сущностью
К объявлению Product можно добавить атрибут:
#[ORM\FullTextIndex(
    name: 'product_search',
    fields: ['name' => 'A'],
    configuration: 'pg_catalog.russian',
    column: 'search_vector',
)]
Он описывает STORED generated tsvector и GIN-индекс. Служебное поле не становится обычным полем сущности и не участвует в её записях. Перед поиском нужно сгенерировать, проверить и применить поддерживаемую миграцию схемы; один атрибут не меняет существующую БД сам по себе.
$products = $em->createQueryBuilder()
    ->fromEntity(Product::class, 'p')
    ->andWhereFullText('p', 'насос для воды')
    ->addOrderByFullTextRank('p')
    ->addOrderBy('p.id')
    ->setMaxResults(20)
    ->getQuery()
    ->getResult();
Выгода: поиск по каталогу можно начать на PostgreSQL с явным mapping и ранжированием, без обязательного отдельного поискового сервиса. Для сложной морфологии, индексации и большого поискового контура пригодность проверяется на ваших данных. FullTextIndex требует PostgreSQL 17+ и поддерживаемого пути SchemaTool; не все изменения источников индекса обрабатываются автоматически. Полнотекстовый поиск и миграции.
8. Курсорная пагинация вместо всё более глубокого OFFSET
Для последовательного просмотра большого каталога есть CursorPaginator. Порядок задаётся mapped-полями корневой сущности и заканчивается первичным ключом.
use ModernORM\Tools\Pagination\CursorPaginator;

$source = $em->createQueryBuilder()->fromEntity(Product::class, 'p');
$paginator = new CursorPaginator(limit: 50, orderBy: ['id' => 'ASC']);
$page = $paginator->paginate($source, $cursor ?? null);

foreach ($page as $product) {
    echo $product->sku;
}
$next = $page->hasNextPage() ? $page->getNextCursorAsString() : null;
Непустая страница обычно использует два запроса: выборку ключей и гидратацию нужных корней. Общее число строк не запрашивается автоматически; getTotalCount() выполняет отдельный COUNT по требованию.
Выгода: навигация не зависит от растущего OFFSET, а приложение контролирует, когда ему действительно нужен общий счётчик. Нужен индекс, подходящий фильтрам и порядку. Nullable-сортировки, сортировка по выражению, relevance score и collection fetch joins не входят в этот контракт. Tenant-условия сохраняются на каждом запросе; курсор не заменяет авторизацию. Условия курсорной пагинации.
9. php-ext-deepclone: ускорение гидратации
После выбора нужной страницы остаётся превратить строки PostgreSQL в PHP-объекты. Здесь ModernORM умеет использовать php-ext-deepclone — нативное расширение PHP. Несмотря на название, для ORM важна его функция deepclone_hydrate(): она позволяет присваивать подготовленные значения полям объекта нативным вызовом вместо отдельных обращений к каждому свойству через PHP-accessors.
Это ускорение включается автоматически для подходящих сущностей. Отдельная настройка EntityManager не нужна. Расширение остаётся необязательным: без него тот же запрос работает через обычный путь гидратации. Оно не меняет SQL, число запросов или способ курсорной пагинации.
// Проверка окружения; вызывать deepclone_hydrate() вручную не нужно.
$nativeHydrationAvailable = extension_loaded('deepclone')
    && function_exists('deepclone_hydrate')
    && defined('DEEPCLONE_HYDRATE_NO_LAZY_INIT');

// Прикладной код одинаков с расширением и без него.
$products = $em->createQueryBuilder()
    ->fromEntity(Product::class, 'p')
    ->setMaxResults(50)
    ->getQuery()
    ->getResult();
Проверка выше показывает наличие необходимых возможностей runtime, но не гарантирует быстрый путь для любого mapping. ORM отдельно проверяет совместимость полей и состояния объекта. Для неподходящих случаев сохраняется обычное присваивание через accessors. Поэтому подключение расширения не требует упрощать всю модель до набора скалярных полей.
Выгода: можно начать проект без дополнительного расширения, а затем ускорять подходящие сценарии загрузки без переписывания репозиториев. Проверять результат нужно на своей выборке: если основное время занимает SQL или сеть, ускорение присваивания полей не даст такого же ускорения всему запросу. Расширение устанавливается и включается в PHP-окружении отдельно от Composer-пакета ORM. Документация гидратора ModernORM.
10. Кеш и встроенные поведения — с явными границами
Entity L2 cache в ModernORM ограничен загрузкой сущности по ID и работает через PSR-6. Сейчас кешируемая сущность не должна иметь объявленных связей. Это полезный контракт для справочников, но не обещание кешировать любой граф приложения.
use ModernORM\Cache\CacheWritePolicy;
use ModernORM\Mapping as ORM;

#[ORM\Entity]
#[ORM\Cacheable(ttl: 3600, writePolicy: CacheWritePolicy::INVALIDATE)]
class Currency
{
    #[ORM\Id, ORM\Column(length: 3)]
    public string $code;

    #[ORM\Column]
    public string $name;
}

// $pool — настроенный PSR-6 cache pool.
$ormConfig->setSecondLevelCache($pool, namespace: 'app_l2_v1');
INVALIDATE допускает обновления через ORM с инвалидированием до записи и после COMMIT. Политика по умолчанию READ_ONLY запрещает ORM-обновления. Она отличается от Immutable: immutable-сущность пропускает обновление своих полей, сохраняя INSERT и DELETE.
Мы проверяли кеш не только на успешном ответе: в репозитории есть испытания с реальным Redis, потерей сокета, рестартом и завершением PHP-процесса после физического COMMIT. Это не делает БД и Redis одной атомарной транзакцией; окно отказа и требования восстановления остаются явно описанными.
В саму ORM также добавлены Timestampable, Blameable и SoftDelete. Они включаются для конкретной сущности. SoftDelete — отдельная политика с restore(), hardDelete(), withDeleted() и onlyDeleted(), а не возвращение универсальных ORM Filters. SoftDelete включён в beta.5; поддерживаются не все сочетания связей, удаления и кеша.
Выгода: типовые правила можно подключать без отдельного пакета поведения, при этом исключения и режимы видимости описаны в одном месте. Документация: L2 cache, испытания Redis и SoftDelete.
11. SQL, flush и hydration можно наблюдать из самой ORM
Встроенная Statistics API собирает число SQL-операций, длительность, ошибки, данные batching и bulk, hydration и фазы UnitOfWork. Сборщик подключается middleware DBAL до создания соединения и по умолчанию выключен. После настройки снимок доступен через EntityManager:
// DBAL Statistics middleware уже настроен для этого соединения.
$statistics = $em->getStatistics();
if ($statistics !== null) {
    $snapshot = $statistics->snapshot();
    printf("SQL: %d; time: %.3f ms
",
        $snapshot->sqlCount,
        $snapshot->sqlTimeMilliseconds(),
    );
    printf("Bulk rows: %d
", $snapshot->bulk->affectedRows);
}
Статистика относится к DBAL Connection. Если несколько EntityManager используют одно соединение, их SQL входит в общий счётчик. В долгоживущем воркере границу сброса задаёт приложение. Число SQL не означает число успешно закоммиченных бизнес-операций.
Для Symfony есть отдельный ModernORMBundle: панели Profiler показывают запросы, UnitOfWork, batching, bulk, кеш и PostgreSQL, а Performance Advisor связывает рекомендации с соответствующими панелями. Прототип экспорта OpenTelemetry — отдельная opt-in интеграция, не обязательная зависимость ядра.
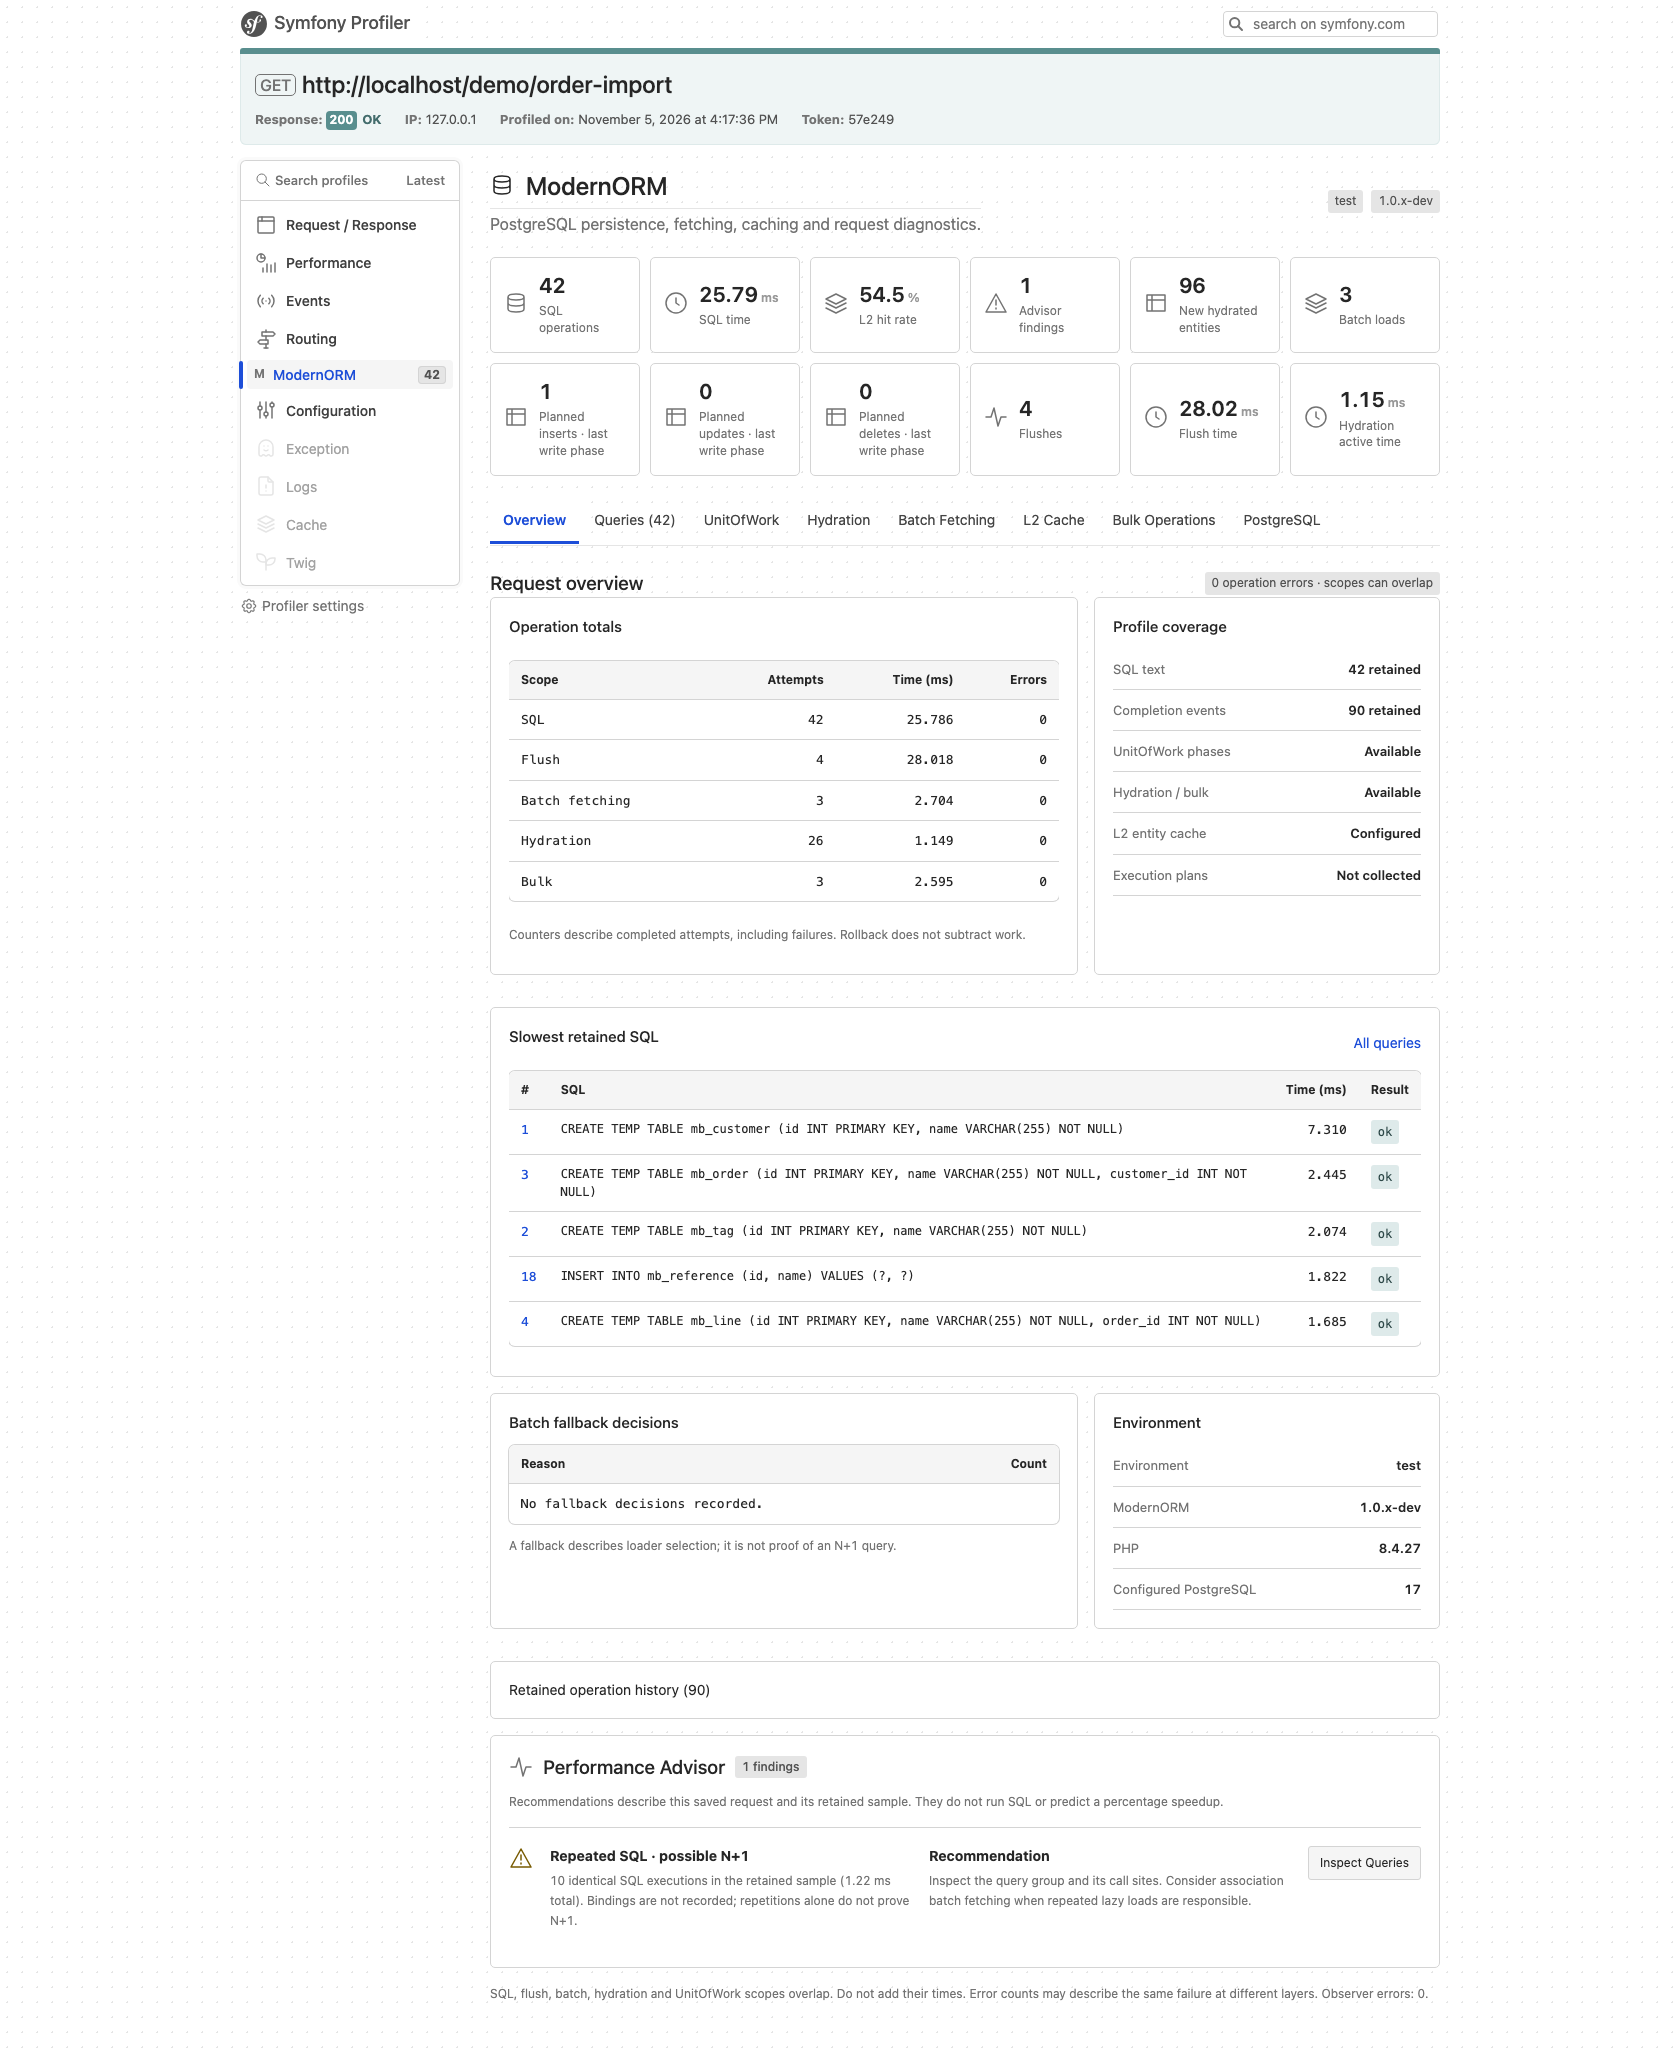
Выгода: легче понять, что именно делает ORM в конкретном запросе или задании, и выбрать оптимизацию по наблюдениям. Подключение Statistics · ModernORMBundle.
12. Как мы рефакторили UnitOfWork: выделяли алгоритмы и контракты
После удаления лишних режимов мы начали выносить обязанности из UnitOfWork. Смысл работы — не уменьшить файл любой ценой, а сделать отдельные решения проверяемыми и сохранить порядок наблюдаемых действий.
| Компонент | Что ему передано | Что остаётся у координатора |
|---|---|---|
| EntityStateManager | Идентификаторы, состояния, исходные snapshots и переходы регистрации / очистки | Identity Map, очереди, lifecycle и транзакции |
| ChangeSetComputer | Сравнение подготовленных scalar/embedded-снимков | Чтение свойств и назначение операций |
| EntityHydrator | Присваивание значений и отдельные решения загрузки связей | Выбор канонического объекта и координация регистрации |
| WriteOrderPlanner | Порядок INSERT, UPDATE и DELETE по соответствующим правилам | Когда и в какой фазе выполнить работу |
| FlushExecutor | Исполнение подготовленного потока записей через persisters | Управление транзакцией, очередями и событиями |
| ScalarChangeTrackingPlan / FlatSqlHydrationPlan | Узкие быстрые пути для подходящих форм данных | Общий путь для остальных mapping и контекстов |
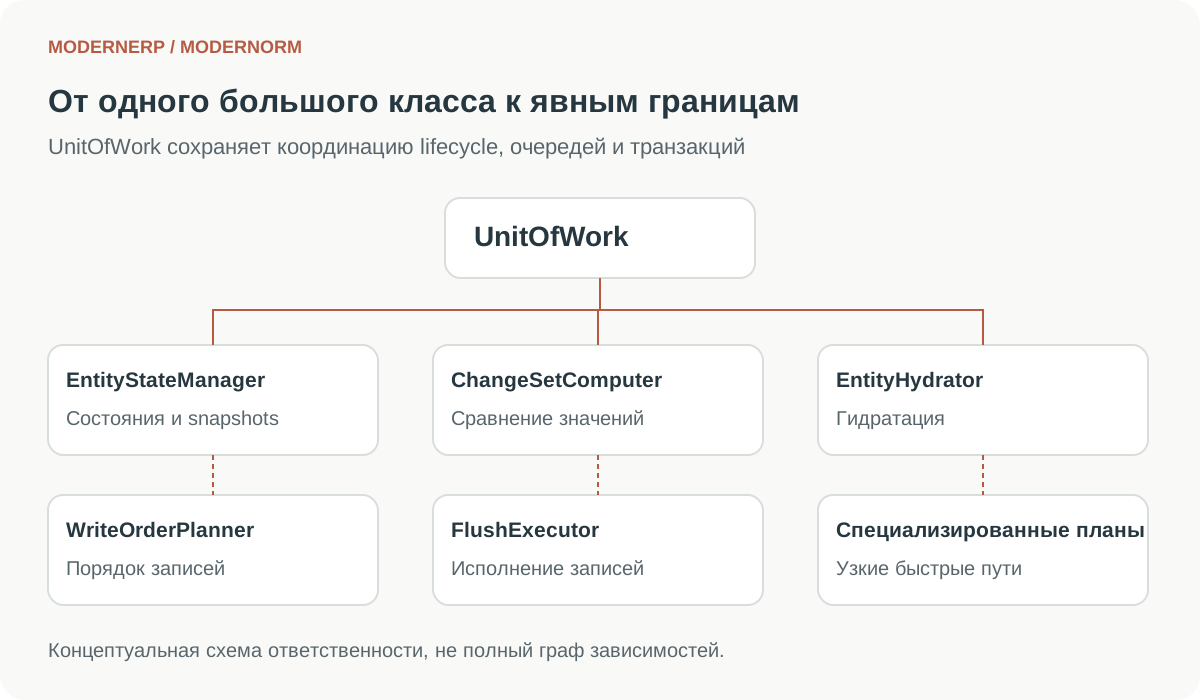
Единственный владелец состояния вместо его копирования
EntityStateManager хранит исходные идентификаторы, состояния и snapshots без параллельной копии тех же данных в новом наборе объектов. Сохраняется поведение массивов PHP copy-on-write. При этом рефакторинг поэтапный: UnitOfWork ещё обращается к внутренним картам менеджера. Мы не выдаём перенос хранения за уже законченную инкапсуляцию.
Сначала проверяемое решение, затем изменение границы
ChangeSetComputer получает metadata и подготовленные значения; ему не нужен EntityManager или SQL. Для FlushExecutor проверяется последовательность подготовки, записи, очистки и событий. Нельзя сначала подготовить все DELETE, если прежнее поведение позволяло событию или ошибке на предыдущем объекте влиять на следующий шаг.
В наборе проверок есть ошибки INSERT/UPDATE/DELETE, сбои callback, deferred FK на COMMIT, новые изменения из postFlush, восстановление после ошибок и работа внешней транзакции. Эти сценарии задают требования к границам компонентов. Перенос методов без сохранения такого поведения не считался завершённой задачей.
Оптимизация распространённого случая без смены публичного API
Scalar dirty-checking fast path объединяет чтение и строгое сравнение обычных скалярных полей за один проход. Он применяется только к подходящим сущностям с нужной политикой и снимками. Связи, embeddables, hooks, readonly, enums и другие неподходящие случаи идут по общему пути.
Для полной плоской SQL-выборки появился query-local план гидратации. При наличии совместимого необязательного ext-deepclone доступен native-путь присваивания; без расширения или при неподходящем mapping остаются accessors. Универсального процента ускорения для всех сущностей мы не заявляем.
Выгода: обычное приложение получает оптимизированные пути без нового ручного режима mapping, а внутренние алгоритмы становятся проще проверять отдельно. Источники: состояние сущностей, сравнение снимков, исполнение записей и быстрый dirty checking.
13. Корректность: что исправляли помимо производительности
В работе над ORM мы разбирали не только стоимость hydration. В репозитории есть аудиты persistence, Identity Map, PostgreSQL write path и границ flush с тестами до и после исправлений.
- Orphan removal: замена коллекции должна удалять настоящих сирот, сохраняя оставшихся участников; удаление одного ключа не должно уничтожать ребёнка, который остался под другим ключом.
- Identity Map: посторонний объект с таким же ID не должен вытеснять зарегистрированный экземпляр через remove или detach.
- Identity INSERT: PostgreSQL RETURNING позволяет получить идентификатор именно своей вставки, включая сценарии с триггерами.
- postFlush: исключение после успешной фиксации не должно повторно выполнять уже завершённые очереди на следующем flush; новые изменения требуют отдельной согласованной обработки.
Это исправления в текущем коде ModernORM. Ссылки на исходные issues Doctrine фиксируют происхождение сценария, а не статус исправления upstream сегодня. Некоторые режимы вместо исправления удалены: пример — EXTRA_LAZY. При этом остаются ограничения, включая замену записей с immediate UNIQUE в одном flush и перестановку двух UNIQUE-значений; они требуют подходящей схемы или явного разделения действий.
Вместо рекламного числа «исправленных багов» предлагаем конкретные сценарии и тесты. Persistence audit · PostgreSQL write audit · Identity Map audit.
В опубликованном релизе приведены результаты CI для PHP 8.4/8.5, разных наборов зависимостей и PostgreSQL 17/18, а также отдельного прогона 19rc1. Указаны проверки Redis/L2, optional deepclone и чистого потребительского приложения. Это отчёт проекта о выбранных сценариях, не сертификация всех возможных mapping. CI ядра beta.5 · CI Bundle beta.5.
14. Ускорения: что изменили и где измеряли результат
Мы ускоряем конкретные участки жизненного цикла сущности: запись полей при гидратации, чтение состояния, вычисление изменений и повторный расчёт после preUpdate. Это позволяет уменьшать накладные расходы ORM, сохраняя общий рабочий процесс приложения.
| Ускорение | Что изменили | Измеренный результат | Статус |
|---|---|---|---|
| Native scalar hydration | Пакетная запись через deepclone_hydrate() | Около 1,47–1,6× на этапе присваивания, не всей загрузки | В beta.5 |
| Пакетная гидратация embedded | Объединяем запись крупных групп scalar-полей | Около 1,09–1,12× в production-пути | В beta.5 |
| Flat SQL Hydration Plan | Заранее определяем допустимость native-записи, передаём готовую строку без пересборки | Дополнительно 1,04–1,10× всей managed-гидратации относительно generic deepclone | В beta.5 |
| ScalarChangeTrackingPlan | Один проход чтения и сравнения для простых сущностей | 1,37–1,64× для computeChangeSets() в контрольном замере | В beta.5 |
| Один PHP cast на entity | Убрали повторные cast и вызовы accessor для каждого поля | 100 000 entities × 20 полей: 615 → 285 мс без изменений; 731 → 393 мс при изменениях | В main, коммит e06dca5 |
| Пакетное чтение при recompute | Тот же принцип после preUpdate, с сохранением merge-семантики | 10 000 entities × 50 полей: recompute 402 → 172 мс, полный flush 2571 → 2343 мс | В main, коммит f821f76 |
Загрузка: меньше работы на каждое поле
Native scalar hydration сокращает стоимость присваивания значений. Для крупных embedded-групп тот же принцип уменьшает число отдельных записей. Flat SQL Hydration Plan идёт дальше: для подходящей полной выборки сущности решение о допустимости быстрого пути подготавливается заранее, а нормализованная строка передаётся без сборки нового массива аргументов на каждой итерации.
Здесь важна база сравнения: дополнительные 1,04–1,10× получены относительно пути, в котором deepclone уже используется. Это измерение managed-гидратации, включающее её внутреннюю работу; выполнение SQL исключено. Оно не означает такого же ускорения HTTP-запроса. Native-пути требуют совместимого расширения и mapping; для остальных случаев остаётся обычная гидратация.
Dirty checking: одно чтение состояния вместо повторных обходов
ScalarChangeTrackingPlan объединяет чтение и сравнение для подходящих простых сущностей. Следующее изменение уменьшает повторную работу ещё и на уровне получения значений: один PHP cast объекта подготавливает состояние для чтения полей. В контрольном сценарии на 100 000 сущностей с 20 полями это сократило время с 615 до 285 мс без изменений и с 731 до 393 мс при изменениях.
Recompute после preUpdate: ускорять, сохраняя результат записи
После preUpdate ORM может повторно вычислять изменения. Пакетное чтение состояния применяется и здесь, с сохранением правил объединения с уже рассчитанным changeset. В сценарии на 10 000 сущностей с 50 полями время recompute уменьшилось с 402 до 172 мс. Полный flush в том же замере сократился с 2571 до 2343 мс — примерно на 9%. Это показывает, почему ускорение отдельной фазы нельзя переносить на весь flush.
Оба последних изменения уже закоммичены в main: чтение состояния одним cast и пакетное чтение при recompute. Их не следует приписывать опубликованной beta.5: для использования нужна версия, включающая эти коммиты.
Выгода для приложения: меньше процессорной работы при загрузке больших выборок и проверке множества managed-сущностей. Коэффициенты из таблицы нельзя перемножать: у замеров разные границы и базы сравнения. Это локальные контрольные результаты, а не сравнение ModernORM с Doctrine и не обещание такого же ускорения вашего проекта.
Описание путей и измерений: EntityHydrator, Flat SQL Hydration Plan, Scalar change tracking и результаты бенчмарков. Статусы сверены с локальным репозиторием 17 ноября 2026 года; полный flush зависит также от SQL, транзакций, связей и обработчиков событий.
15. Что показывают измерения и чего они не обещают
В репозитории сохранены методика и сырые результаты локальных запусков. Ниже сравниваются режимы самой ModernORM. Это не сравнительный тест ModernORM против Doctrine.
| Сценарий | Исходный режим | Другой режим |
|---|---|---|
| 100 заказов и 100 разных клиентов | Batch size 1: 101 SELECT | Batch size 32: 5 SELECT |
| INSERT 10 000 строк, медиана | UnitOfWork: 493,19 мс | Bulk BYPASS: 59,66 мс |
| UPDATE 10 000 строк, медиана | UnitOfWork: 687,82 мс | Bulk BYPASS: 15,75 мс |
Batch-пример выполнен на PHP 8.4.27 и PostgreSQL 17.11 на macOS. Bulk-замеры — на PHP 8.4.27, DBAL 4.5.0 и PostgreSQL 17.11; это исторический артефакт, а не повторный замер текущей ветки с DBAL 4.6. Для bulk использовались три измеренных раунда после прогрева. UPDATE через UnitOfWork включает загрузку целей; bulk пропускает обычные callbacks и отслеживание объектов, поэтому семантика разная.
Для L2 вывод особенно полезен: в сохранённом локальном сценарии batched-чтение PostgreSQL оказалось быстрее тёплого Redis L2. Меньше SELECT не всегда означает меньшую задержку. Хорошая ORM должна давать выбор и измерения, а не включать кеширование как безусловное ускорение.
Выгода: можно воспроизвести интересующий сценарий, проверить его на своей сети и данных и принять решение по числу запросов, времени, памяти и корректности. Условия и результаты измерений. Непубликуемые локальные диагностические замеры в эти цифры не включены.
16. Как начать новый проект
Если ваш стек — PHP 8.4+, PostgreSQL и модель с одним скалярным ID, ModernORM позволяет с самого начала использовать SQL-first репозитории, batching и явный выбор между объектными и bulk-операциями. Не придётся сначала накапливать DQL и сложные mapping, чтобы потом от них отказываться.
Установка ORM beta.5:
composer require 'andreybolonin/modernorm:^0.1.0-beta.5'Для Symfony можно установить ORM и Bundle совместимых версий:
composer require 'andreybolonin/modernorm:^0.1.0-beta.5' 'andreybolonin/modernorm-bundle:^0.1.0-beta.5'Bundle требует Symfony FrameworkBundle 7.4 или 8.x и DBAL 4.6. Фиксируйте разрешённые версии через composer.lock. Минимальный исполняемый пример конфигурирует DBAL, AttributeDriver и EntityManager; Symfony-проект может использовать конфигурацию bundle.
Практический первый шаг — перенести один понятный сценарий: справочник и список со связями, небольшой импорт или API с JSONB. Запишите исходное число SQL и проверьте поведение при повторной записи и ошибке. После этого расширяйте модель.
Начать: исполняемый пример persistence · документация ModernORM · интеграция с Symfony.
17. Когда имеет смысл перейти с Doctrine ORM
Сильный кандидат на переход — PostgreSQL-приложение, где большая часть модели укладывается в поддерживаемый mapping, а команда регулярно решает N+1, массовые загрузки, JSONB-запросы и диагностику persistence. В этом случае стоимость отказа от лишней универсальности можно обменять на полезные возможности в ежедневной разработке.
| Шаг | Что сделать |
|---|---|
| Инвентаризация | Найти DQL, Criteria, ORM Filters, inheritance, составные ID и partial load |
| Модель | Проверить атрибуты ModernORM, ключи, связи, cascades и callbacks |
| Запросы | Переписать DQL в SQL API; отдельно проверить полные entity-проекции и строки |
| Symfony | Перевести repository и сервисы; не рассчитывать на прозрачную замену ServiceEntityRepository |
| Границы записи | Воспроизвести flush, rollback, UNIQUE-конфликты, bulk и кеш |
| Обновление | Очистить или версионировать metadata/query/hydration caches и перезапустить долгоживущие воркеры |
| Приёмка | Сравнить данные, SQL, длительность и память на одинаковом сценарии |
Начинайте с ограниченного контура. Bundle допускает сценарии сосуществования с DoctrineBundle на отдельных сервисах и соединениях, но это не общая Identity Map двух ORM и не автоматическая совместимость расширений. Границу данных и транзакций нужно задать явно.
Если приложение критически зависит от DQL-расширений, discriminator-наследования, составных ID или нескольких СУБД, стоимость перехода может перевесить выгоду. Для существующего проекта PostgreSQL — необходимое, но не достаточное условие.
Именно такую ORM мы развиваем: с понятной специализацией, явными контрактами и инструментами для задач, которые регулярно возникают в ERP, интеграциях и приложениях с большим объёмом данных.
Исходники и границы проверки
Материал подготовлен и обновлён под опубликованные ModernORM beta.5 и ModernORMBundle beta.5. Ссылки на документацию ядра закреплены за тегом v0.1.0-beta.5. Примеры сверены с API; измерения относятся к условиям сохранённых benchmark-артефактов, а не к независимому повторному тестированию релиза при подготовке статьи.
ModernORM на GitHub · Пакет Composer · Открытые проекты ModernERP.
Для Symfony мы подготовили отдельный разбор: ModernORMBundle: подключение, Profiler, миграции и мониторинг.