Содержание статьи
- Почему зелёный сервер ещё не означает работающий обмен
- Какие метрики собирать
- Пример: очередь сокращается, но поток ещё не восстановлен
- Пример правила оповещения Prometheus
- Что должно быть в сообщении дежурному
- Какие действия могут усугубить инцидент
- Как определить бизнес-границу успешной операции
- Дашборд для оператора и для руководителя
- Как выбирать пороги и уменьшать шум
- Журналы, метрики и трассировка работают вместе
- Инструкция восстановления и проверка закрытия
- Как проверить сам мониторинг
- Источники и дата проверки
- Контроль документа и SaaS-наблюдение за обменом
Почему зелёный сервер ещё не означает работающий обмен
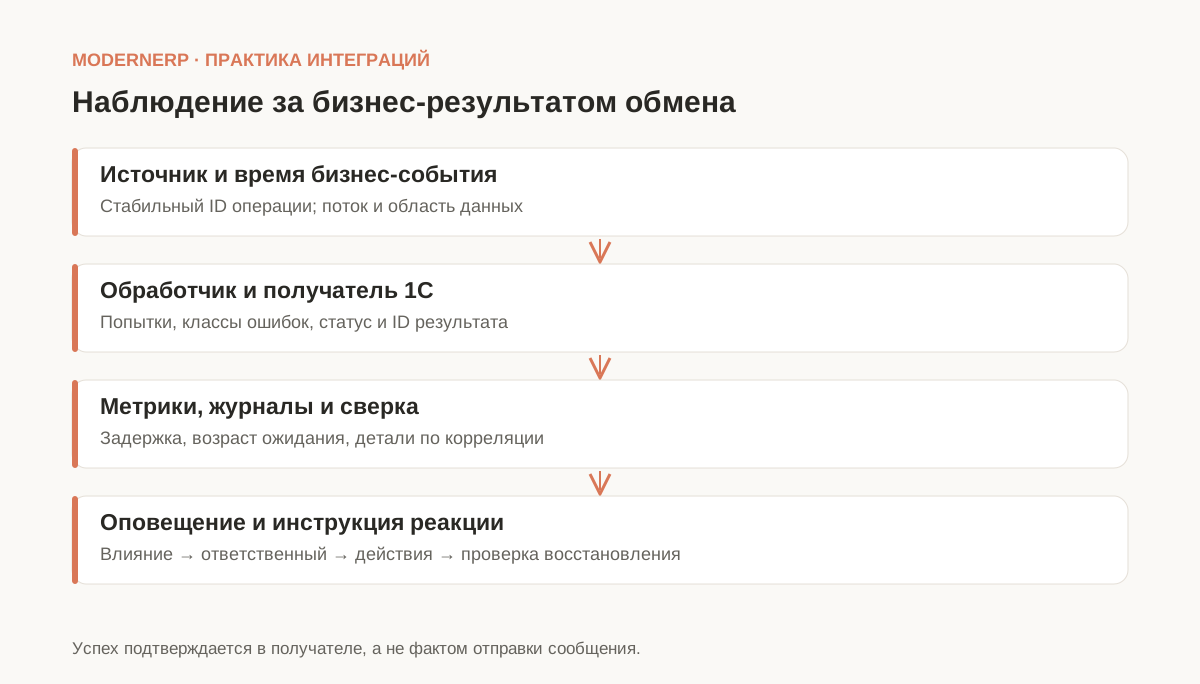
Процесс может отвечать на HTTP-запросы, пока заказы стоят в очереди или документы отвергаются из-за незнакомой номенклатуры. Мониторинг интеграции должен показывать путь до бизнес-результата: событие принято, обработано и отражено в системе-получателе. Доступность транспорта — только один слой.
Начните с одного важного потока, например «заказ CRM → документ 1С». Согласуйте, что считается завершением, за какое время результат нужен бизнесу и кто реагирует на сбой. Для редкой ночной выгрузки правила будут другими, чем для потока заказов в рабочее время.
Какие метрики собирать
| Метрика | Что показывает | Типичная ловушка |
|---|---|---|
| Входящие и завершённые операции | Интенсивность и успешные результаты | Считать подтверждение транспорта успешной записью |
| Возраст старейшей ожидающей операции | Риск нарушения срока обработки | Смотреть только длину очереди |
| Время от события до результата | Задержку для пользователя | Измерять лишь время HTTP-вызова |
| Ошибки по классам | Сбой сети, авторизации или бизнес-валидации | Смешивать временный сбой и некорректные данные |
| Время последней успешной плановой загрузки | Актуальность пакетного обмена | Не учитывать расписание |
| Расхождения сверки | Неотражённые или лишние бизнес-объекты | Сравнивать только общее число строк |
Имена метрик в примере собственные. В лейблах оставляйте ограниченные значения: поток, окружение, класс результата. ID каждого заказа помещайте в журнал или трассировку, иначе кардинальность метрик будет расти вместе с числом заказов.
Пример: очередь сокращается, но поток ещё не восстановлен
Учебный поток должен завершать не менее 99% заказов за 5 минут в рабочее время. На контрольном интервале поступило 1 000 заказов, 980 завершились в пределах срока, 15 позже, 5 остались без результата. Доля соблюдения срока — 980 / 1 000 = 98%, хотя в итоге отражено уже 995 заказов.
Это упрощённая закрытая выборка: всем операциям дали истечь пяти минутам. В живом скользящем окне нельзя включать новые события, срок которых ещё не наступил, как просроченные. Согласуйте также момент отсчёта, часы работы и исключения: без них красивый процент нельзя воспроизвести.
Если очередь сократилась с 500 до 20 сообщений, а старейшему ожидающему заказу уже 40 минут, это не повод закрыть инцидент. Проверьте оставшиеся сообщения, карантин ошибок и сверку ID на стороне 1С. Отдельно учитывайте операции с неопределённым результатом после таймаута.
Пример правила оповещения Prometheus
Допустим, обработчик публикует gauge integration_oldest_pending_age_seconds для потока crm_orders. Ноль означает, что ожидания нет; отсутствие метрики не трактуется как ноль. Ниже учебное правило по возрасту, которое дополняют отдельной проверкой доступности экспортёра.
groups:
  - name: integration-demo
    rules:
      - alert: IntegrationPendingTooOld
        expr: integration_oldest_pending_age_seconds{flow="crm_orders"} > 300
        for: 2m
        labels:
          severity: warning
        annotations:
          summary: "Заказ CRM ожидает обработки больше пяти минут"
Условие должно оставаться истинным две минуты до срабатывания. Это задерживает уведомление сверх пяти минут; если требование жёсткое, порог и for выбирают с учётом времени реакции. Дополнительно проверяйте недоступность экспортёра через up или согласованный сигнал отсутствия данных. Для пакетного потока используйте расписание и допустимую задержку, а не это правило без изменений.
Что должно быть в сообщении дежурному
Правило Prometheus создаёт состояние alert, но само по себе не настраивает доставку человеку. Для уведомлений подключают Alertmanager или согласованный внешний обработчик, задают получателей и маршруты. Проверьте доставку тестовым сигналом и отдельно контролируйте работоспособность самого канала оповещения.
Укажите поток и окружение, возраст проблемы, бизнес-влияние, ссылку на дашборд, журнал и инструкцию. Назначьте ответственного и заместителя. Десятки одинаковых уведомлений от каждого узла лучше группировать; плановое обслуживание должно иметь согласованное подавление, а не отключение контроля навсегда.
- Проверить, доступен ли получатель и действуют ли учётные данные.
- Разделить ошибки на временные, бизнес-валидацию и неопределённый результат.
- Посмотреть несколько операций по ID, не раскрывая секреты и полные документы в уведомлении.
- Устранить причину, затем разрешить ограниченный повтор по контракту.
- Сверить конечные документы и оставшиеся просрочки.
Какие действия могут усугубить инцидент
| Действие | Риск |
|---|---|
| Повторить всё одним запуском | Дубли и перегрузка получателя |
| Удалить ошибочные сообщения | Потеря операций и доказательств |
| Считать пустую очередь успехом | Сообщения могли попасть в карантин или потеряться |
| Проверять только доступность URL | Бизнес-обработка может быть сломана |
| Поставить одинаковый порог всем потокам | Шум от штатных задержек и пропуск важных сбоев |
Безопасные повторы разобраны в статье о дублях документов. Мониторинг обнаруживает проблему, но не заменяет защиту принимающей системы от повторной записи.
Как определить бизнес-границу успешной операции
Для заказа успехом может быть созданный черновик, проведённый документ или подтверждённое резервирование. Это разные результаты с разными сроками. Если интеграция завершает измерение после приёма сообщения, а пользователь ждёт проведения, показатель будет слишком оптимистичным. Запишите начальное и конечное события и подтвердите, что их можно наблюдать по устойчивому ID, а не только по тексту лога.
Разделите принятые, отклонённые и ещё не завершённые операции. Бизнес-отказ из-за запрещённой организации не обязательно означает поломку транспорта, но должен быть виден владельцу процесса. Не исключайте неудобные ошибки из отчёта ради высокого процента успеха. Согласуйте, какие случаи входят в обещание сервиса и как отражаются отказы, отмены и намеренно отложенная обработка.
Для асинхронного потока начало и конец могут находиться в разных системах. Сохраните корреляцию и происхождение временных меток. Если часы существенно расходятся, отрицательная или искусственно большая задержка не является свойством бизнеса. Контролируйте синхронизацию и выбирайте надёжный способ измерения. Для сквозного показателя полезнее один согласованный метод, чем множество несопоставимых таймеров отдельных сервисов.
Дашборд для оператора и для руководителя
Оператору нужны активные проблемы: какой поток задержан, насколько старые операции, каков класс ошибки и где инструкция. Руководителю важнее исполнение обещанного срока, влияние на заказы и динамика восстановления. Одна панель со всеми техническими графиками редко удобна обоим. Разделите уровни представления, сохранив переход от агрегата к конкретному примеру без раскрытия лишних данных.
Для очередей показывайте не только размер, но и возраст старейшего элемента, скорость поступления и завершения. Если входящий поток остановился, очередь может уменьшаться без реального улучшения источника. Если ошибки выводятся в отдельный карантин, пустая основная очередь тоже обманчива. На панели должно быть видно полное распределение состояний, включая ручное вмешательство и неопределённый результат.
Показывайте момент последнего получения метрик и успешного бизнес-результата отдельно. Экспортёр может работать, пока получатель больше не создаёт документы. И наоборот, отсутствие новых заказов ночью может быть штатным. Для редкого потока используйте ожидание по расписанию или контрольный безопасный сценарий, а не требование непрерывного роста счётчика. Любой синтетический тест должен быть отделён от реальных операций.
Как выбирать пороги и уменьшать шум
Начните с бизнес-срока и необходимого времени реакции. Если оператору нужно двадцать минут на восстановление, сигнал за минуту до предельного срока слишком поздний. При этом ранний порог без устойчивого условия может порождать десятки уведомлений о коротких штатных колебаниях. Сравните историю задержек и согласуйте предупреждение отдельно от аварийного сигнала, требующего немедленного вмешательства.
Разделите симптомы и причины. Недоступность одного общего получателя может вызвать ошибки во многих потоках. Группировка и подавление зависимых уведомлений помогают не потерять главное, но должны оставлять видимым бизнес-влияние. Не скрывайте все сигналы только потому, что известна техническая причина. Ответственный должен понимать, какие заказы и сроки затронуты, даже если отдельное уведомление для каждого потока не отправляется.
После каждого шумного правила разберите, какую полезную реакцию оно предполагает. Если получатель не знает, что делать, уведомление постепенно начинают игнорировать. Удаление бесполезного сигнала и замена его проверкой результата иногда лучше усложнения порога. Сохраняйте историю изменений правил, чтобы понимать, вызвано уменьшение числа инцидентов улучшением системы или простым ослаблением контроля.
Журналы, метрики и трассировка работают вместе
Метрика показывает масштаб и момент проблемы, журнал объясняет отдельную операцию, а трассировка помогает пройти между компонентами. Не пытайтесь хранить все документы в метриках. Высокая кардинальность ухудшает эксплуатацию, а чувствительное содержимое расширяет круг доступа. В журнале полезны ID операции, тип действия, версия контракта, класс ошибки и ссылка на разрешённую детализацию.
Для временной ошибки фиксируйте попытку и план следующего действия. Одинаковые сообщения без номера попытки затрудняют диагностику: неизвестно, это тысяча проблемных заказов или один заказ, повторённый тысячу раз. Сохраняйте исходный ключ операции между попытками и отдельный ID технического вызова. Тогда можно объяснить и бизнес-результат, и сетевую историю, не смешивая эти понятия.
Доступ к журналам также требует ролей и срока хранения. Полный токен или файл договора не должен попадать в общее уведомление. Проверьте обезличивание и маскирование на реальном формате ошибок: библиотеки иногда включают параметры запроса в текст исключения. Диагностика должна оставаться полезной после удаления секретов; заранее определите минимальный набор полей, необходимый поддержке.
Инструкция восстановления и проверка закрытия
Инструкция должна описывать безопасные действия по классам ошибок. Для недоступности получателя — проверка и ограниченный повтор, для неизвестной номенклатуры — исправление соответствий, для неопределённого исхода — сверка до новой записи. Общая кнопка «переотправить всё» не является универсальным лечением. Особенно осторожно работайте с оплатами, отгрузками и внешними электронными документами.
Инцидент закрывается после восстановления бизнес-состояния, а не только доступности процесса. Сверьте просроченные операции, карантин и конечные ID, убедитесь в отсутствии дублей и новых хвостов. Зафиксируйте длительность, причину, затронутый объём и последующее действие. Регулярная учебная проверка инструкции показывает, сможет ли дежурный восстановить поток без автора интеграции и доступа ко всем системам сразу.
Как проверить сам мониторинг
В тестовом контуре остановите получателя, отзовите тестовый токен, передайте неизвестную номенклатуру и выключите экспортёр. Проверьте время появления сигнала и получение уведомления ответственным. После восстановления сверьте бизнес-операции: исчезновение красной панели само по себе не критерий.
Сохраните исходную выборку, правила расчёта задержки и журнал реакции. Первый полезный результат — обнаруживаемый сбой одного потока с понятной инструкцией. Расширяйте покрытие по критичности, включая загрузку аналитической витрины.
Скачать учебный пример (YAML). Перед запуском адаптируйте его к тестовому контуру.
Для учебного инцидента заранее запишите ожидаемую последовательность: появление просрочки, устойчивое условие правила, получение уведомления, начало реакции и восстановление бизнес-результата. После испытания сравните фактические времена с планом. Если сообщение пришло, но никто не назначен ответственным, техническая доставка работает, а процесс реакции ещё не принят. Это отдельный дефект организации сопровождения.
Источники и дата проверки
Проверено . Prometheus: инструментирование; Prometheus: организация оповещений; Prometheus: правила оповещения.
Контроль документа и SaaS-наблюдение за обменом
Дополнено .
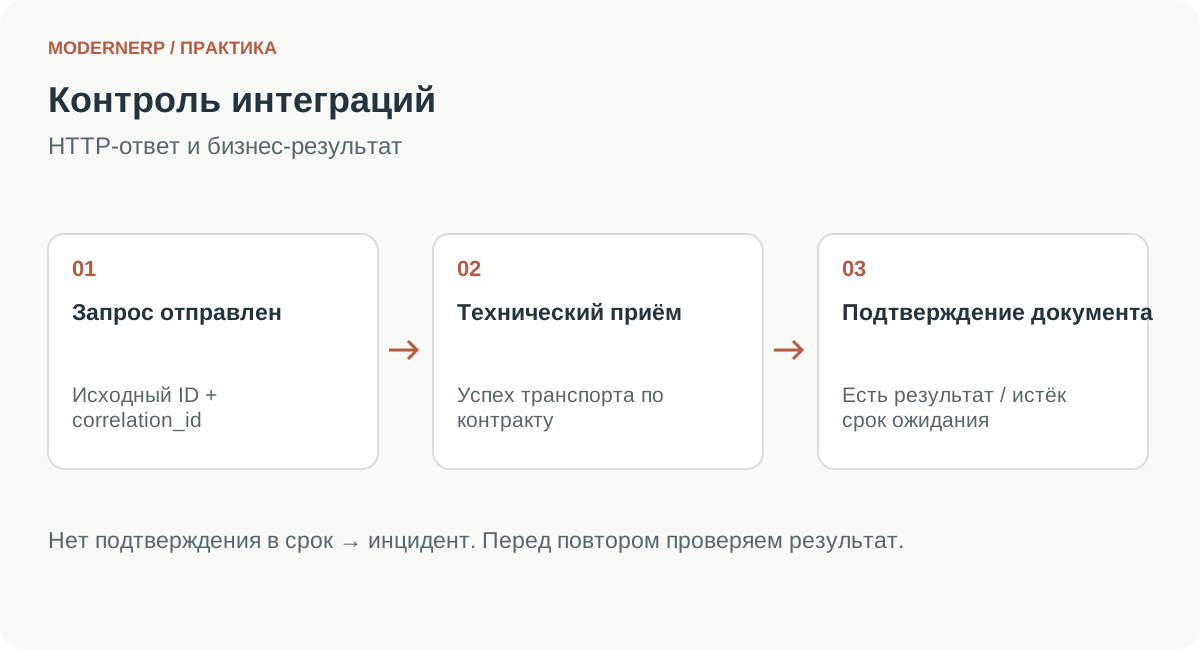
К техническим метрикам добавьте ожидаемые этапы бизнес-операции. Для заказа это могут быть приём запроса, запись в 1С и подтверждение склада. Согласуйте, какой из них означает результат для бизнеса. Успешный HTTP-ответ трактуется по контракту API: для асинхронного задания он не обязательно подтверждает создание конечного документа.
События связываются через исходный ID, пространство идентификаторов и correlation_id. Храните время события и время получения: задержка доставки наблюдений не должна незаметно превращаться в задержку самого заказа. При отсутствии подтверждения проверьте heartbeat источника, а перед повторной записью — наличие результата у получателя.
ModernERP Integration Monitor создаётся как SaaS на серверах ModernERP. Системы клиента продолжают обмениваться напрямую и отправляют согласованные события по HTTPS; события и история мониторинга хранятся у ModernERP. Полные тела документов и секреты по умолчанию не передаются. На подключении согласуются минимальный набор полей, срок хранения и каналы уведомлений.
Недоступность сервиса наблюдения не должна блокировать основной обмен: испытайте асинхронную передачу, ограничения буфера и поведение при исчерпании повторов. Это требование к конкретной реализации подключения, а не повод считать любую доставку событий безошибочной.
Первая версия концепции включает события, задержки, heartbeat, каталог и уведомления. Сверка документов через API получателя и специальные адаптеры 1С относятся к V2. Возможности и условия пилота подтверждаются отдельно. Подробнее: проверка пути заказа и сравнение своего инструмента с SaaS. Концепция Integration Monitor и подключение.
Для первичной проверки используйте чек-лист остановки обмена 1С. Для выбора инструментов — сравнение журнала регистрации, Zabbix, Grafana и специализированного мониторинга.