Какие вопросы подходят для RAG
«Когда подать заявку на командировку?», «Какие условия возврата действуют для этого договора?» — вопросы, где ответ опирается на документ. RAG помогает найти основание и сформулировать ответ, но не превращает устаревший регламент или плохой скан в надёжный источник.
Если нужен текущий остаток или сумма дебиторской задолженности, обращайтесь к расчётному инструменту, а не к похожему тексту. Для небольшого набора документов может хватить поиска и просмотра сотрудником: генерация ответа нужна, если она действительно упрощает использование найденного материала.
Шаг 1. Ограничить корпус и определить владельцев
Для пилота выберите одну предметную область: например, действующие правила командировок. Составьте перечень документов, редакций, владельцев и групп доступа. Исключите черновики, дубли и материалы, на которые сотрудникам нельзя опираться как на действующие правила.
Заранее договоритесь, что считается актуальным документом и кто разрешает спор между двумя источниками. Если владелец не может выбрать действующую редакцию, это нерешённая задача управления документами. Увеличение контекста модели её не устраняет.
Шаг 2. Подготовить фрагменты с проверяемым происхождением
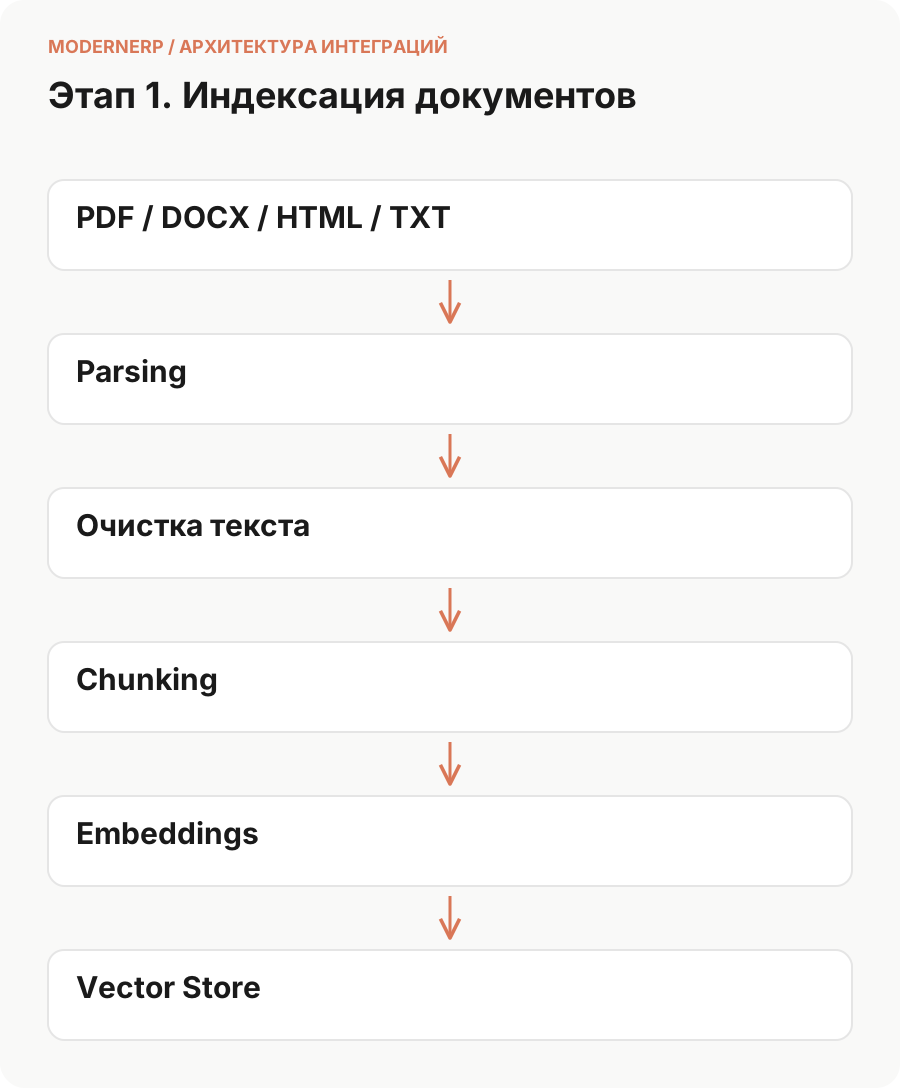
Извлеките текст и отдельно проверьте таблицы, списки и сканы. Делите по смысловым границам: пункт регламента с условиями и исключением должен оставаться понятным. Фиксированное число символов удобно технически, но может разорвать правило и относящееся к нему ограничение.
{
  "document_id": "travel-policy",
  "revision": "v3",
  "section": "4.2",
  "valid_from": "2026-10-01",
  "access_group": "employees",
  "source_ref": "Внутренний архив: travel-policy, v3, пункт 4.2",
  "text": "Заявку подают не позднее пяти рабочих дней до поездки."
}
Поля — пример метаданных, не универсальный формат продукта. Храните достаточно сведений, чтобы открыть точное основание ответа. Embeddings создавайте одинаковой совместимой моделью для корпуса и вопроса; при её смене планируйте переиндексацию.
Шаг 3. Применить права и актуальность при поиске
Сервис определяет пользователя, доступный корпус и действующие редакции до формирования контекста для LLM. Найденный фрагмент не должен попадать в промпт, лог или кеш чужой группы. Фильтр в приложении после уже сгенерированного ответа слишком поздний.
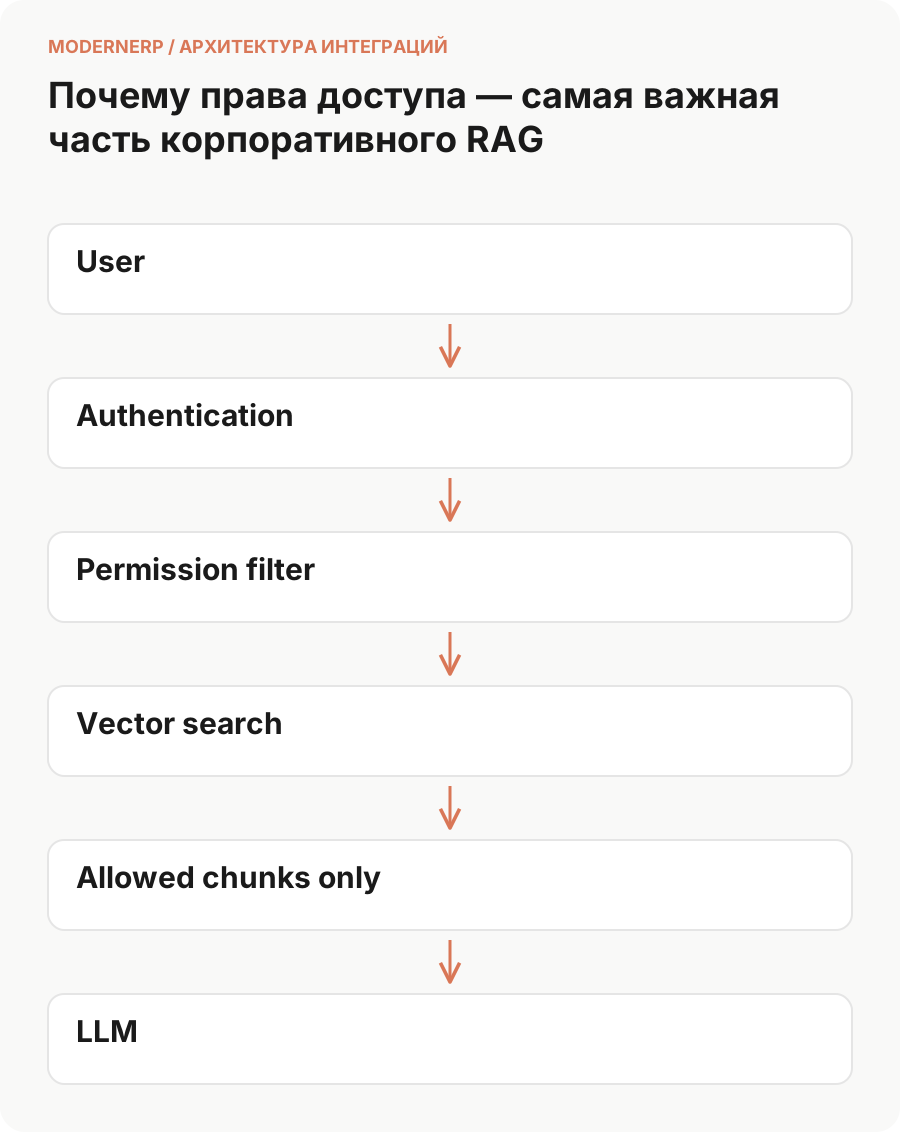
Технический порядок фильтрации внутри поискового движка может различаться. Важен результат границы доступа: генератор получает только разрешённые фрагменты. Проверяйте это на документах с похожими заголовками и разными правами, а не только на очевидно секретном файле.
Шаг 4. Сформировать ответ и показать основание
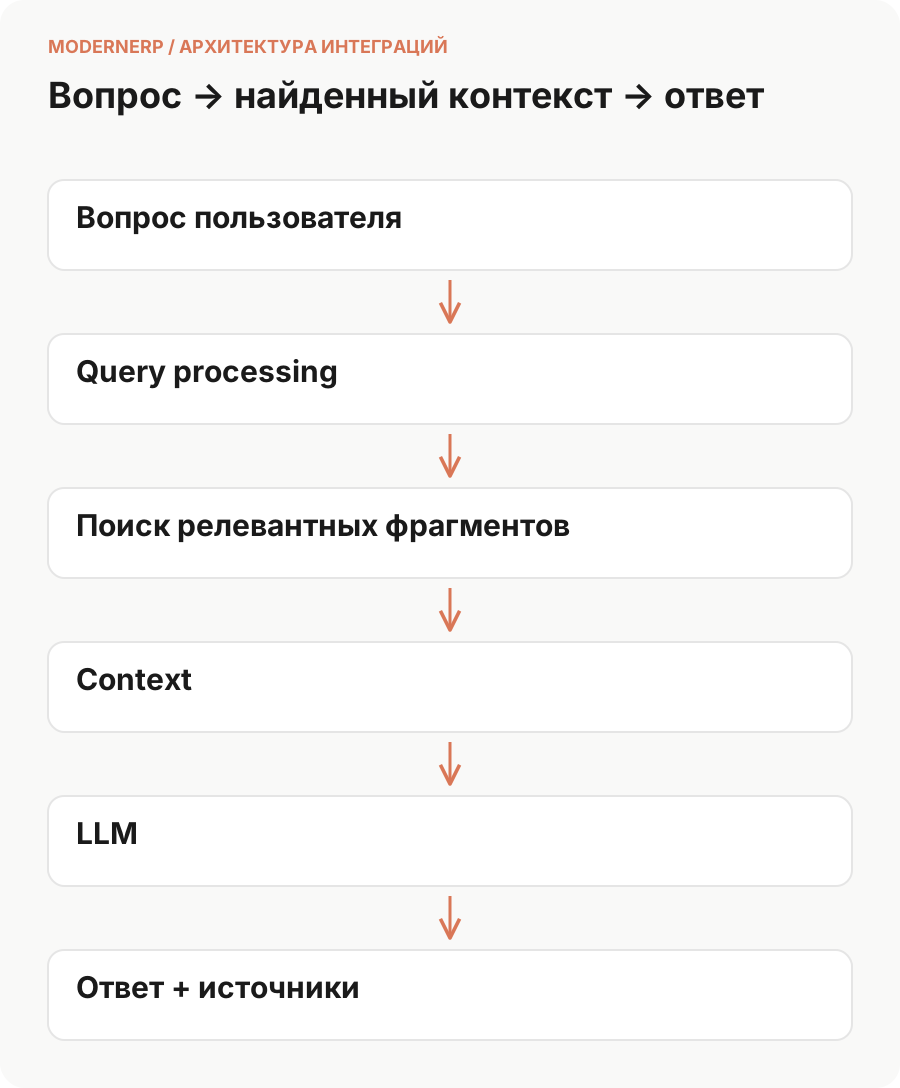
Передайте вопрос и отобранные фрагменты с их идентификаторами. Попросите отвечать только по этим основаниям и явно отмечать недостаток информации. Проверка приложения должна убедиться, что ссылки ведут на существующие разрешённые фрагменты; модель может придумать ссылку так же, как текст.
Разобранный учебный пример: в архиве есть старая редакция v2 со сроком «три дня» и действующая v3 со сроком «пять рабочих дней». Пользователь спрашивает: «За сколько подавать заявку?» После фильтрации редакций в контекст попадает пункт 4.2 версии v3. Корректный ответ: «Не позднее пяти рабочих дней до поездки; основание — регламент v3, пункт 4.2».
Теперь вопрос: «Можно подать завтра, если директор разрешит?» Если во фрагментах нет такого исключения, система должна сообщить, что основание не найдено, и направить к владельцу процесса. Уверенное «да» по общим знаниям модели — ошибка, даже если в компании иногда так поступают.
Как обновлять документы без смешения редакций
Новую редакцию подготовьте отдельно: извлечение, фрагменты, индекс и контрольные вопросы. После проверки переключите доступную редакцию и исключите старые фрагменты из выдачи. Для удаления документа нужен проверяемый путь удаления из индекса и кеша.
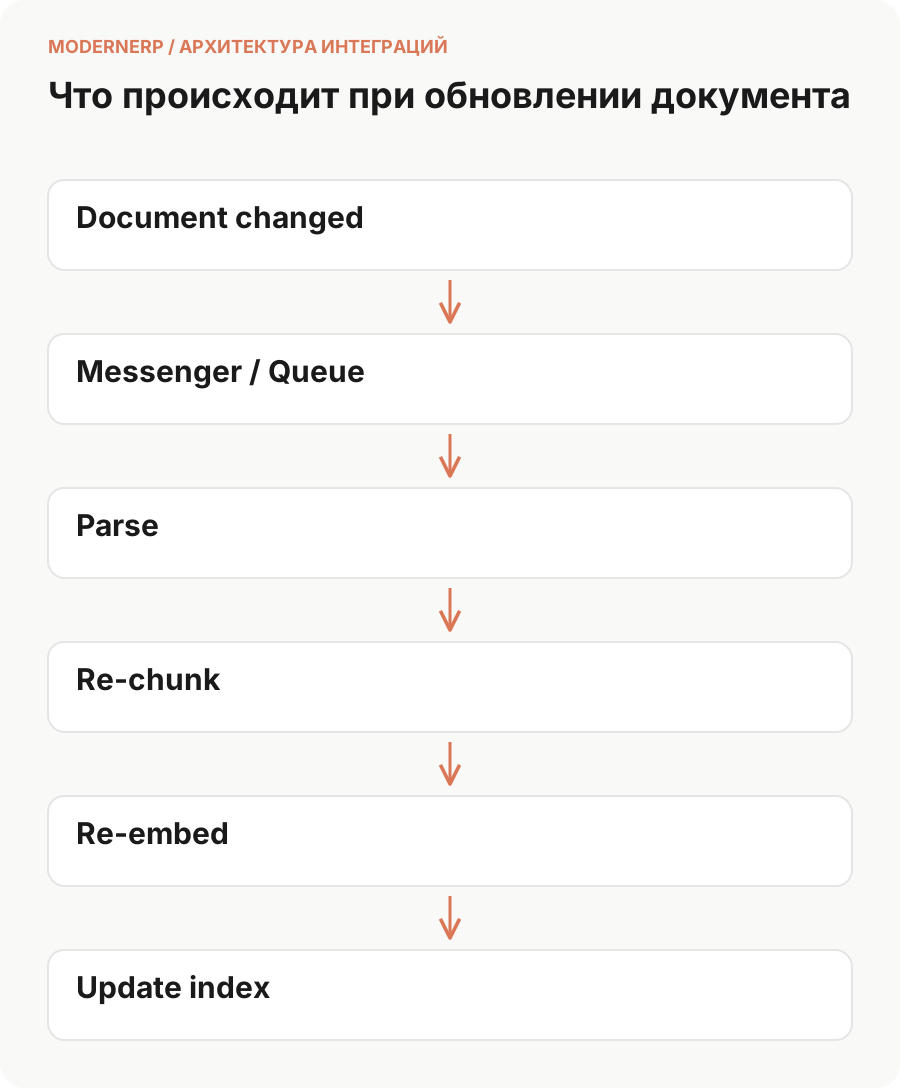
Ключ кеша должен учитывать не только вопрос, но и доступ пользователя и версию корпуса. Иначе после изменения регламента или прав сотрудник может получить старый ответ с корректно выглядящей ссылкой. Для отката сохраните версию корпуса и настройки поиска.
Что делать при плохой выдаче и противоречивом ответе
| Ситуация | Где искать причину |
|---|---|
| Нужный документ есть, но не найден | Извлечение текста, границы фрагмента, способ поиска и фильтры |
| Фрагмент найден, но ответ неверен | Потерянное исключение, смешение источников или ошибка генерации |
| В ответе старая редакция | Состояние индекса, фильтр актуальности и кеш |
| Ответ содержит чужие сведения | Права корпуса, контекст, журналы и область действия кеша |
| Ответа в документах нет | Корректный отказ; сбор запроса владельцу базы знаний |
Не начинайте диагностику с замены LLM. Если нужный пункт не попал в контекст, более дорогая модель может лишь убедительнее заполнить пробел. Сохраняйте безопасный диагностический след: версию корпуса, найденные ID, применённые фильтры и причину отказа.
Как измерить поиск, ответ и сквозной результат
Составьте независимые контрольные вопросы с эталонным пунктом, редакцией и допустимой ролью. Отдельно включите вопросы без ответа и попытки получить чужие документы. Для настройки поиска используйте другую выборку.
Учебный расчёт: из 50 вопросов с основанием в корпусе нужный фрагмент найден в top-5 для 40: recall@5 = 80%. Из этих 40 ответов принято 30: качество ответа при найденном основании — 75%, а сквозная доля принятых ответов на исходной выборке — 60%. Эти величины отвечают на разные вопросы.
Для вопросов без основания считайте уверенные ошибки и корректные отказы отдельно. Доступ к запрещённому документу — самостоятельный дефект, даже если текст фактически верен. Пользовательскую пользу измеряйте временем до проверенного ответа и числом исправлений, включая открытие источника.
Как выбрать реализацию и принять пилот
Если существующий портал или документооборот уже умеет искать с нужными правами и показывать источники, проверьте его первым. Отдельная векторная БД и собственный backend не обязательны. При выборе своего поиска сравните варианты на одном корпусе по методике оценки векторного и гибридного поиска.
Минимальная приёмка: нужная редакция находится, ответ подтверждён фрагментом, чужие данные недоступны, отсутствие основания приводит к отказу, обновление и удаление воспроизводимы. Если эти условия не выполнены, расширять корпус на всю компанию рано.
Запуск локальной модели описан в статье про Ollama, инфраструктура — в материале про on-premise. Для чисел из учёта используйте разрешённые показатели и инструменты, а не поиск по документам.
Редакционный пример обновлён . Данные регламента и показатели качества учебные. Технические контракты: Ollama Embed API и документация pgvector.