Какую задачу решает векторный поиск
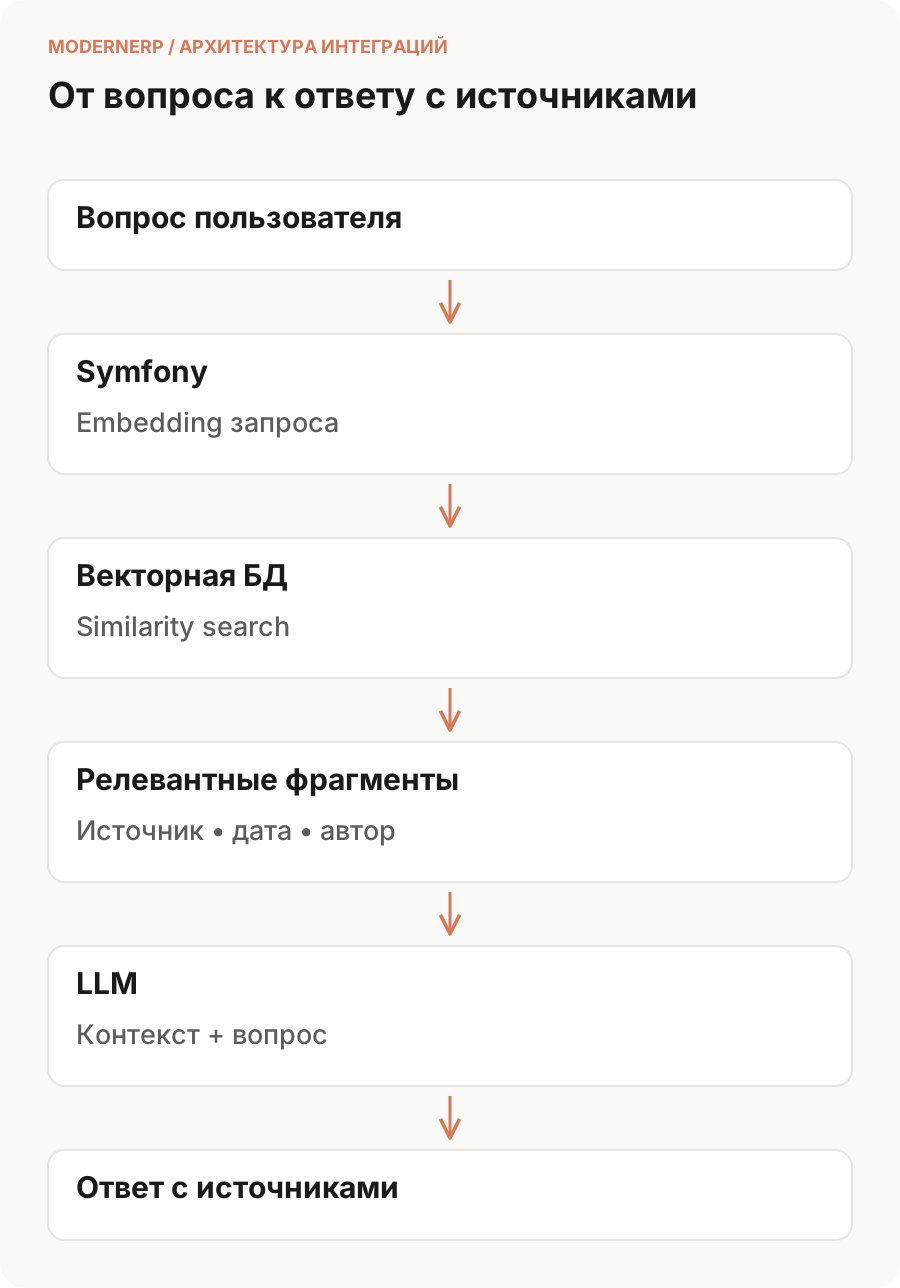
Векторный поиск находит близкие представления текстов. Это полезно, когда пользователь и документ описывают одно понятие разными словами: «замена поставщика» и «выбор альтернативного контрагента». Поиск по номеру договора, артикулу или точной цитате часто лучше начать с обычного фильтра или полнотекстового индекса.
Наличие векторного индекса само по себе не гарантирует правильный ответ. Он возвращает кандидатов, а приложение проверяет права, актуальность и достаточность найденных фрагментов. Как собрать весь процесс ответа с источниками, разобрано отдельно: RAG по корпоративным документам.
Сначала подготовьте контрольные запросы
Возьмите реальные вопросы из обращений сотрудников. Для каждого вручную отметьте документы, которые действительно отвечают на вопрос, и документы, доступные этому пользователю. Включите точные идентификаторы, синонимы, опечатки, вопросы без ответа и материалы с ограниченным доступом.
Учебный пример: в каталоге есть карточки «КЛ-17», «КЛ-71», регламент замены поставщика и устаревшая редакция этого регламента. Для запроса «паспорт КЛ-17» правильна конкретная карточка; близкое написание «КЛ-71» не делает другую карточку релевантной. Для вопроса «как выбрать альтернативного поставщика» нужен действующий регламент. Одним тестом нельзя оценить оба типа поиска.
Сравните простой поиск, векторный и гибридный на одной выборке. В гибридном варианте совпадение артикула можно проверять отдельным правилом, а смысловой поиск применять к описанию. Не выбирайте победителя по нескольким красивым ответам модели: сначала оцените найденные документы без генерации.
Какие варианты сравнивать
| Вариант | Когда включать в сравнение | Что проверить |
|---|---|---|
| Существующий поиск | Есть полнотекстовый индекс, фильтры или поиск в корпоративном портале | Хватает ли качества на ваших вопросах без новой инфраструктуры |
| PostgreSQL и pgvector | Команда уже обслуживает PostgreSQL, нужны SQL и связи с метаданными | Время поиска, размер индекса, влияние нагрузки на основную БД и восстановление |
| Qdrant | Нужен отдельный сервис векторного поиска с фильтрами по payload | Правила фильтрации, обновления, резервирование и эксплуатация отдельного сервиса |
| Pinecone | Рассматривается управляемый сервис | Подходящий регион, условия обработки данных, лимиты, фильтры и текущая стоимость |
Универсального порога «после N документов нужна отдельная база» нет. На результат влияют размерность вектора, число фрагментов, фильтры, параллельные запросы и требуемая задержка. Сравнивайте решения на одинаковом корпусе и сценарии, включая обновления во время поиска.
Минимальный пример pgvector: расстояние и доступ
Ниже учебный SQL для отдельной тестовой PostgreSQL с установленным pgvector. Три координаты заданы вручную, чтобы показать механику косинусного расстояния. Это не настоящие embeddings документов и не доказательство качества смыслового поиска. Временная таблица существует только в текущем соединении.
CREATE EXTENSION IF NOT EXISTS vector;
CREATE TEMP TABLE demo_chunks (
    id integer PRIMARY KEY,
    tenant_id integer NOT NULL,
    body text NOT NULL,
    embedding vector(3) NOT NULL
);
INSERT INTO demo_chunks VALUES
    (1, 7, 'Первый разрешённый фрагмент', '[1,0,0]'),
    (2, 7, 'Второй разрешённый фрагмент', '[0.9,0.1,0]'),
    (3, 8, 'Чужой документ', '[1,0,0]');

SELECT id, body, embedding <=> '[1,0,0]'::vector AS distance
FROM demo_chunks
WHERE tenant_id = 7
ORDER BY embedding <=> '[1,0,0]'::vector, id
LIMIT 2;
Ожидаемый порядок: ID 1 с расстоянием 0, затем ID 2 с расстоянием примерно 0,006116. ID 3 имеет идеальное совпадение вектора, но исключён условием доступа. В приложении организация определяется проверенным контекстом пользователя и передаётся параметром запроса; её нельзя доверять тексту вопроса или ответу модели.
Такой фильтр показывает один уровень изоляции. Для реального корпуса дополнительно учитывают группы, права на отдельные документы и срок действия редакции. До передачи фрагмента модели приложение обязано убедиться, что пользователь вправе его читать.
Как оценивать качество и скорость индекса
Разделяйте две проверки. Первая — насколько найденные документы отвечают на вопрос по разметке эксперта. Вторая — насколько приближённый индекс воспроизводит ближайших соседей точного поиска с той же моделью embeddings и теми же фильтрами. Высокая точность второй проверки не исправит неподходящую модель или плохое разбиение документов.
Для первой проверки можно считать долю вопросов, для которых нужный фрагмент оказался в первых пяти результатах. Отдельно учитывайте вопросы без ответа и нарушения прав: их нельзя скрыть внутри среднего показателя релевантности. Для второй сравнивайте наборы результатов точного и приближённого поиска при одинаковом k.
В pgvector точный поиск доступен без приближённого индекса. HNSW и IVFFlat меняют баланс скорости и полноты. При фильтрации приближённый поиск может вернуть меньше подходящих строк, чем ожидалось: проверяйте это на реальных селективных фильтрах и сверяйтесь с возможностями установленной версии. Отсутствующий результат не всегда означает отсутствие документа.
Измеряйте p50 и p95 задержки, долю запросов без нужного документа, потребление памяти и диска, время добавления новых данных и восстановления. Сохраняйте параметры модели, индекса, фильтров и нагрузку рядом с результатами, иначе сравнение не воспроизвести.
Почему обновления важны не меньше поиска
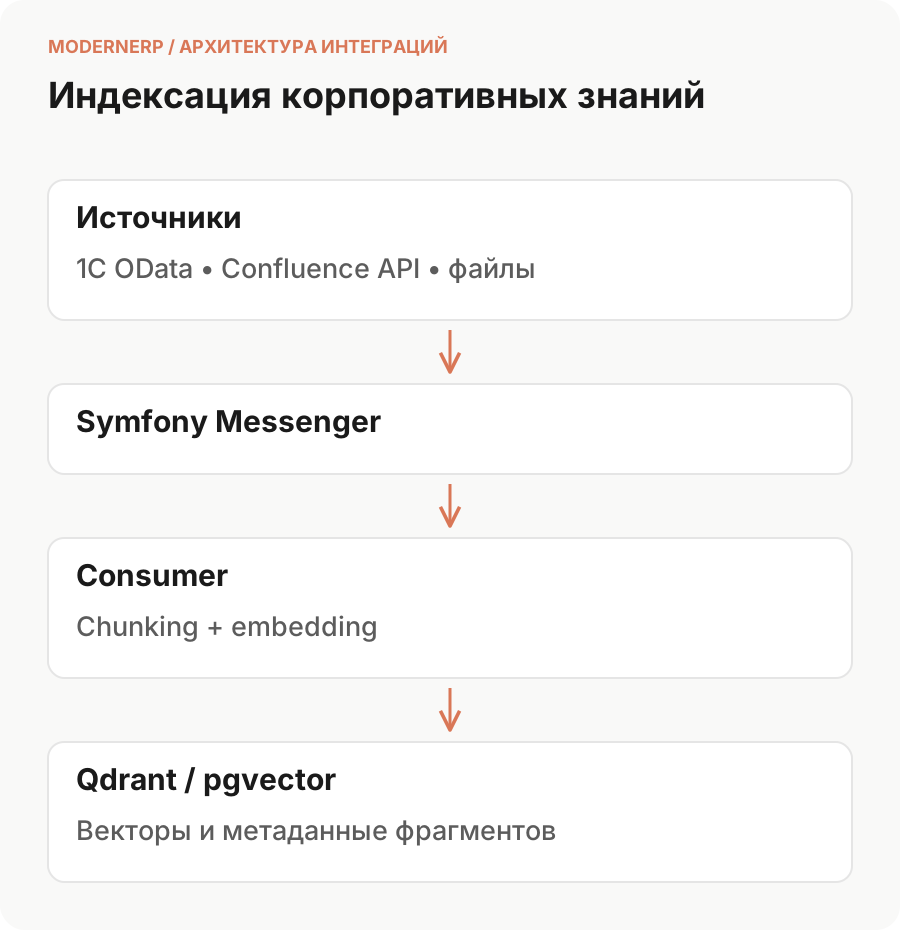
У фрагмента должны быть стабильный ID документа, версия, источник и метаданные доступа. При смене модели embeddings обычно нужен пересчёт корпуса: векторы разных моделей нельзя смешивать только потому, что у них совпала размерность. Новую версию индекса сначала проверяют, затем переключают поиск с возможностью отката.
Удаление документа и отзыв прав должны распространяться на индекс, хранилище текста и кэш ответов. Проверьте это отдельным тестом: найдите документ, отзовите доступ и повторите тот же запрос. Старый ответ из кэша тоже считается утечкой.
Как принять решение по пилоту
До запуска согласуйте допустимые ошибки, задержку и бюджет эксплуатации. Зафиксируйте победивший вариант вместе с условиями: корпус, модель, фильтры, нагрузка и способ обновления. Если обычный поиск уже закрывает вопросы пользователей, новый векторный сервис можно не вводить. Если поиск хорош, но ответ модели неверен, исправлять нужно генерацию и проверку источников, а не менять базу вслепую.
Следующий шаг — пилот на ограниченном корпусе с владельцем документов. Подготовку текста и проверку ответа смотрите в инструкции по RAG, требования к размещению — в материале об on-premise инфраструктуре.
Проверено 17 октября 2026 года. Первоисточники: pgvector, фильтрация Qdrant, фильтрация Pinecone. SQL и набор документов — учебные примеры; сравнительный бенчмарк продуктов здесь не проводился.